
Inhaltsverzeichnis – Analyse – Auswahl
Wie das Deutsche Buch- und Schriftmuseum mit Automatisierung und KI neue Wege bei der Auswahl von Publikationen geht
Das Deutsche Buch- und Schriftmuseum (DBSM) sammelt neben seinen musealen Beständen (Studiensammlungen) auch internationale Publikationen für die Fachbibliothek. Über die Pflichtablieferung der Deutschen Nationalbibliothek erhält das Museum einen umfassenden Überblick über neu erschienene deutschsprachige Publikationen. In der Vergangenheit erfolgte die Auswahl von Titeln, die für die eigenen Sammlungs- und Forschungsschwerpunkte von besonderem Interesse sind, vor allem anhand der physisch vorliegenden Publikationen. Die eingegangenen Werke wurden gesichtet und hinsichtlich ihrer möglichen Relevanz für die Sammlungen bewertet. Dieses Vorgehen ermöglichte eine unmittelbare fachliche Einschätzung, war bei wachsenden Publikationsmengen jedoch mit einem entsprechend hohen personellen und zeitlichen Aufwand verbunden. Angesichts knapper werdender Personalressourcen wurden nun auch im Kontext dieser musealen Kernaufgabe automatische Prozesse aufgesetzt und in die Praxis überführt.
Dabei änderten sich zugleich auch andere Geschäftsgange rund um die Fachbibliothek, die eine Effizienzsteigerung in anderen Bereichen zur Folge hatten: Die ausgewählten Werke werden künftig nicht mehr physisch in den Magazinen des DBSM aufgestellt, sondern über eine virtuelle Verknüpfung mit der Fachbibliothek zugänglich gemacht. Damit entstand die Frage, wie die Auswahl künftig effizienter und möglichst frühzeitig auf Grundlage der bereits vorhandenen digitalen Informationen unterstützt werden kann.
Das Inhaltsverzeichnis als Schlüssel
Bei der Suche nach einer geeigneten Datengrundlage zeigte sich schnell: Nicht jede bibliografische Angabe ist gleichermaßen aussagekräftig. Titel oder Verlag können erste Hinweise liefern, sind für eine thematische Auswahl aber häufig zu ungenau. Auch eine Auswahl anhand der DDC wäre mit einem erheblichen manuellen Aufwand verbunden und ermöglicht nicht immer eine eindeutige Gruppierung der für das DBSM relevanten Themen.
Das Inhaltsverzeichnis bietet dagegen einen besonders direkten Einblick in die inhaltliche Ausrichtung eines Werkes.
Ein weiterer entscheidender Vorteil der Nutzung von Inhaltsverzeichnissen für die Literaturauswahl ist, dass die digitalisierten Inhaltsverzeichnisse über eine direkte Schnittstelle gezielt aufgerufen werden können. Dadurch müssen die Dokumente nicht manuell zusammengetragen werden, sondern können automatisiert abgerufen und verarbeitet werden. Mithilfe der OCR-Texterkennung wird der Inhalt der digitalisierten Inhaltsverzeichnisse für die maschinelle Verarbeitung zugänglich gemacht. Anschließend können die Texte automatisiert nach festgelegten Stichworten durchsucht werden.
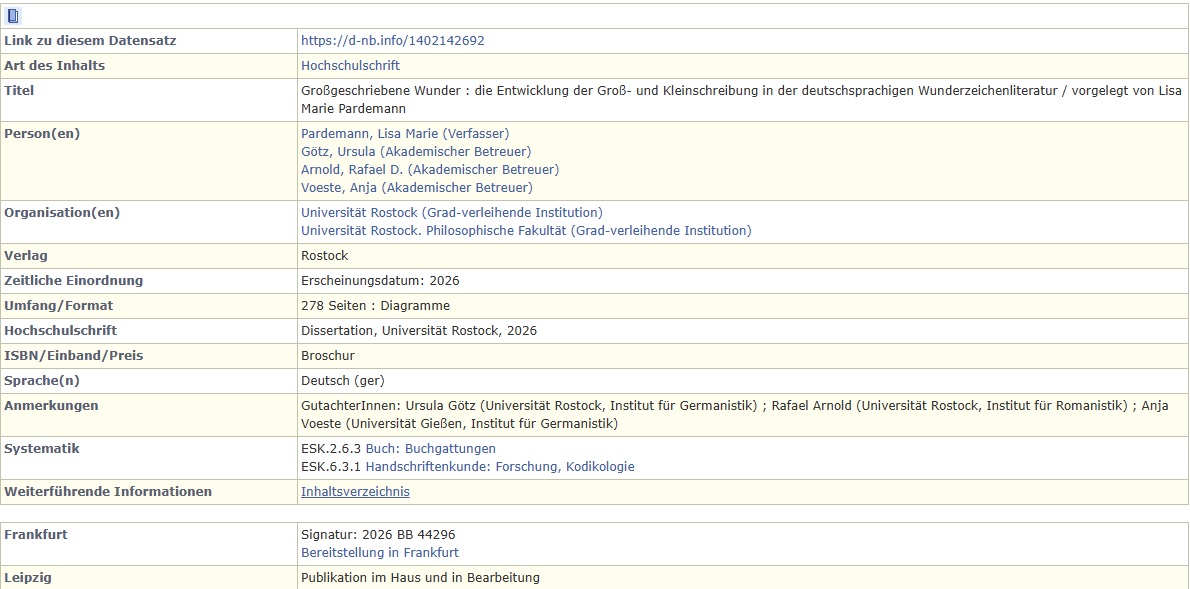
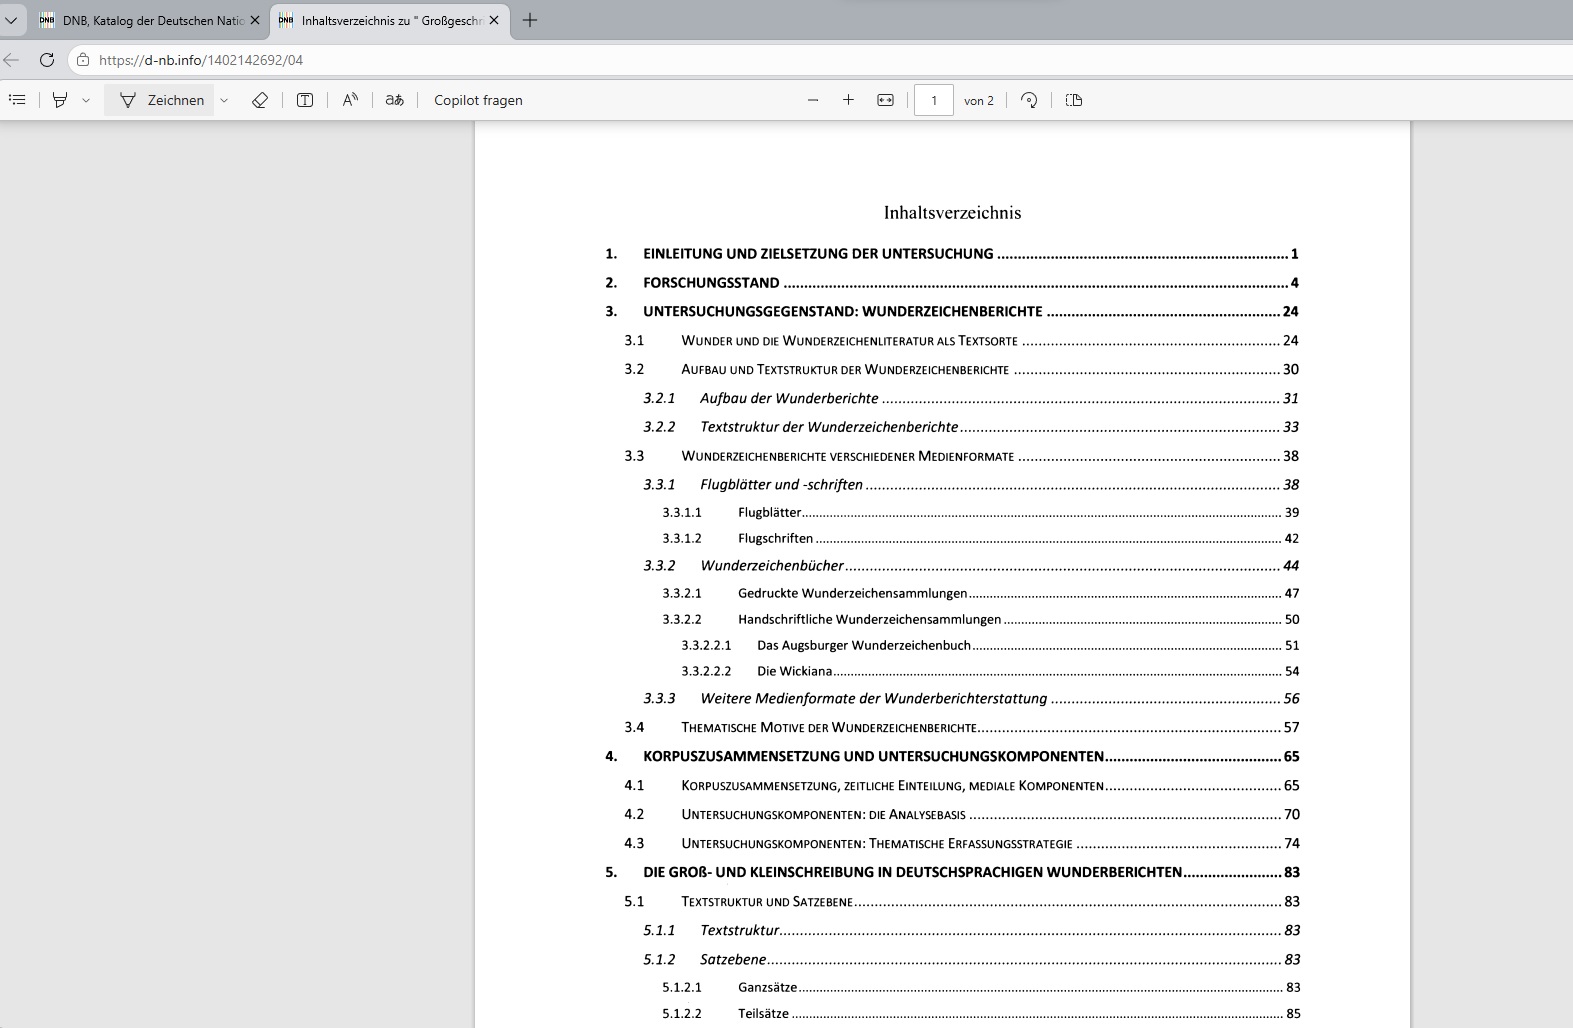
Damit entsteht folgende Prozesskette:
Schnittstelle → Inhaltsverzeichnis → OCR-Texterkennung → Stichwortsuche → Bewertung
Diese Kombination aus direktem Zugriff und maschinell auswertbarem Text bildet die Grundlage für die weitere Automatisierung.
Von der Stichwortsuche zur Gewichtung
Als Grundlage für die Auswahl wurde zunächst eine Liste relevanter Stichworte erstellt. Dabei wurde schnell deutlich, dass nicht jedes Stichwort gleich aussagekräftig ist. Ein Begriff wie „Verlag“ kann beispielsweise grundsätzlich interessant sein, kommt aber sehr häufig in allgemeinen Zusammenhängen vor. Ein spezifischer Begriff wie „Verlagswesen“ liefert dagegen einen deutlich stärkeren Hinweis auf eine mögliche Relevanz für das DBSM.
Deshalb wurden die Stichworte gewichtet. Die verwendete Gewichtung ist:
3 – hohe Relevanz: Der Begriff kann bereits allein ein starkes Indiz für einen relevanten Inhalt gewertet werden.
2 – mittlere Relevanz: Der Begriff ist aussagekräftig, kann aber unterschiedliche Bedeutungen haben.
1 – geringe Relevanz: Der Begriff ist grundsätzlich interessant, sollte aber möglichst zusammen mit weiteren Stichworten auftreten.
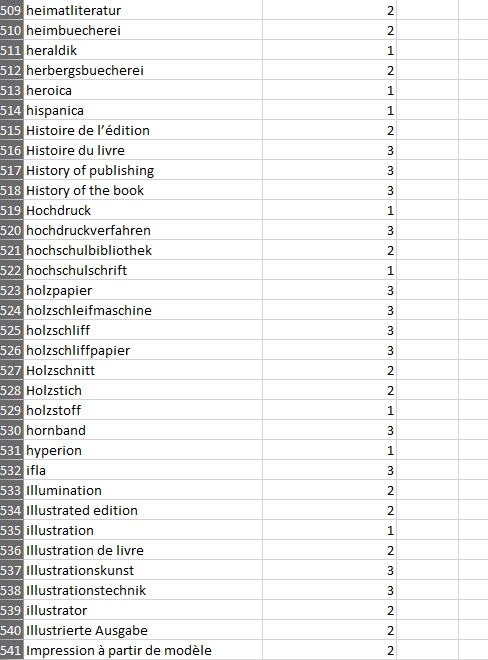
Wortstämme und spezifische Begriffe
Die Suche erfolgt nicht nur nach exakt übereinstimmenden Begriffen. Durch den Einsatz regulärer Ausdrücke können auch Wortstämme berücksichtigt werden. So kann beispielsweise das Stichwort „Druck“ auch Begriffe wie „Drucker“, „Druckerei“, „Druckverfahren“ oder „Druckwesen“ erfassen. Gleichzeitig können spezifische Begriffe zusätzlich hinterlegt und höher gewichtet werden:
| Druck | 1 |
| Druckwesen | 3 |
Dadurch bleiben allgemeine Begriffe erhalten, ohne dass spezifischere Fachbegriffe an Bedeutung verlieren.
Die ersten Ergebnismengen
Die ersten automatisierten Suchläufe waren ein wichtiger Meilenstein in der Entwicklung. Sie zeigten, welche Stichworte besonders häufig miteinander auftreten und welche Begriffe zu viele Treffer in einem für das DBSM nicht relevanten Kontext erzeugen. Ein Beispiel ist der Begriff „Konservierung“, der sowohl im Bereich der Buch- und Papierrestaurierung als auch in für das DBSM völlig fachfremden Zusammenhängen verwendet wird.
Auf Grundlage der ersten Ergebnisse wurden die Stichwortliste und die Gewichtungen schrittweise angepasst. Zusätzlich wurde eine Mindestgewichtung definiert. Nur Datensätze, deren erreichte Gesamtgewichtung einen bestimmten Schwellenwert überschreitet, werden für die weitere Verarbeitung berücksichtigt.
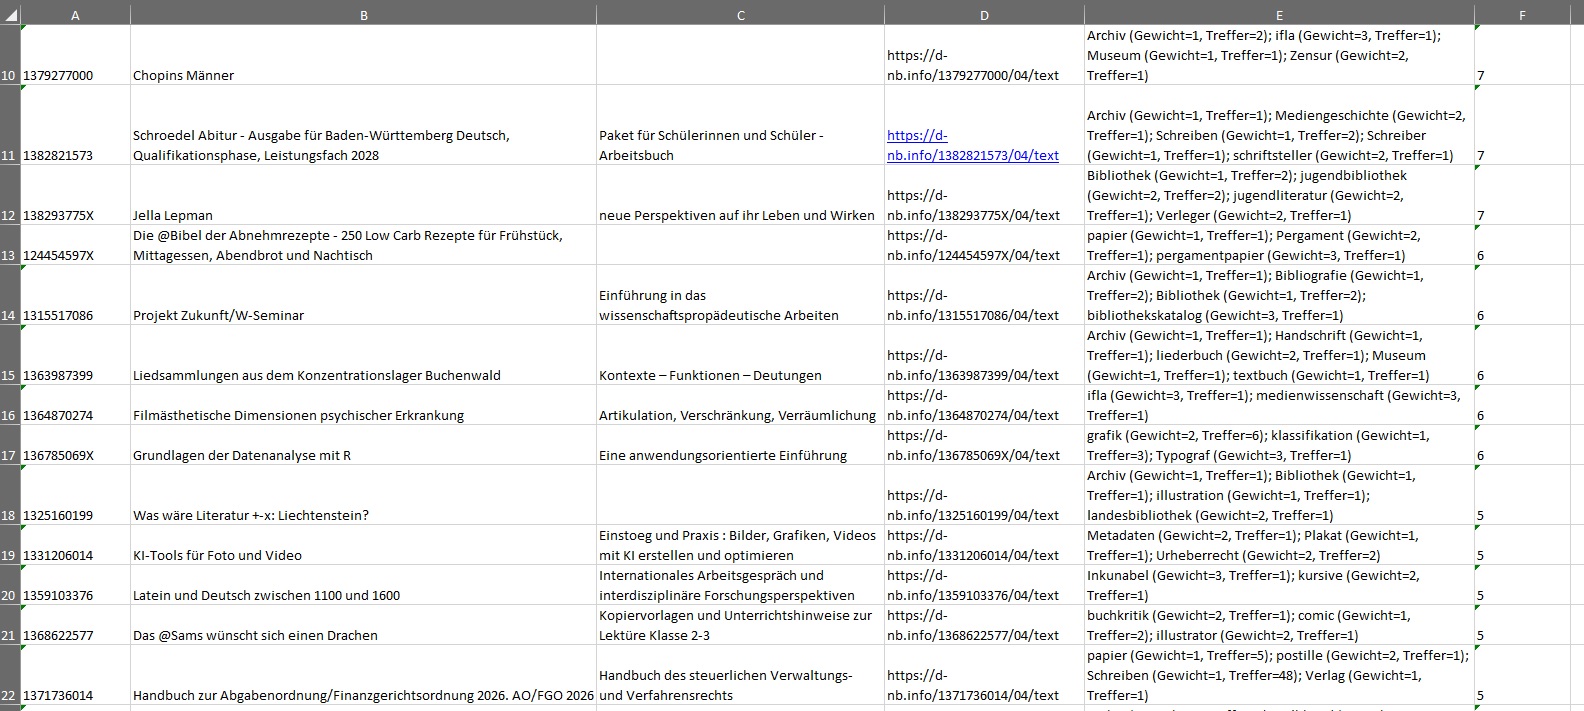
Anbindung an die KI
Die Stichwortsuche liefert eine sehr gute Möglichkeit, große Mengen an Inhaltsverzeichnissen automatisiert vorzusortieren. Sie hat jedoch eine Grenze: Ein Stichwort allein sagt noch nicht immer etwas über den tatsächlichen Kontext aus. Daher kam bezüglich der Stichwortsuche die Idee auf, Künstliche Intelligenz ergänzend einzusetzen. Durch die Möglichkeit, eine KI-Schnittstelle der GWDG zu nutzen, konnte die automatische Vorauswahl um eine inhaltliche Relevanzprüfung erweitert werden. Die KI prüft dabei, ob der Inhalt eines Werkes bzw. seines Inhaltsverzeichnisses thematisch für den Sammlungsbestand des Deutschen Buch- und Schriftmuseums relevant ist.
Dabei berücksichtigt sie unter anderem:
- Buch- und Schriftgeschichte
- Drucktechniken und grafische Verfahren
- Schriftgestaltung
- Papier und andere Beschreibstoffe
- Restaurierung
- Bibliotheks- und Museumswesen
- Verlagswesen
- Buch- und Medienkunst
- Mediengeschichte
- verwandte handwerkliche, künstlerische und technische Verfahren
Entscheidend ist dabei nicht nur das Vorhandensein eines Begriffes, sondern der Zusammenhang, in dem er verwendet wird. Ein anschauliches Beispiel ist das Stichwort „Buchdrucker“. Es kann sich um einen historischen Beruf im Buchdruck handeln – oder um den Buchdrucker, einen Käfer. Die KI kann – entsprechend trainiert – diesen inhaltlichen Unterschied bei der Bewertung berücksichtigen.
Drei Kategorien statt einer einfachen Ja-Nein-Entscheidung
Die KI trifft dabei keine reine Ja-Nein-Entscheidung. Sie ordnet die Werke in drei Kategorien ein:
| Relevant | Teilweise relevant | Nicht relevant |
| Das Werk behandelt überwiegend Themen, die für den Sammlungsbestand des DBSM von Bedeutung sind. | Das Werk enthält relevante Aspekte, der Schwerpunkt liegt jedoch auf anderen Themen. Diese Werke können gezielt einer fachlichen Prüfung zugeführt werden. | Das Werk weist keinen oder nur einen zufälligen bzw. nicht ausreichenden thematischen Bezug zum DBSM auf. |
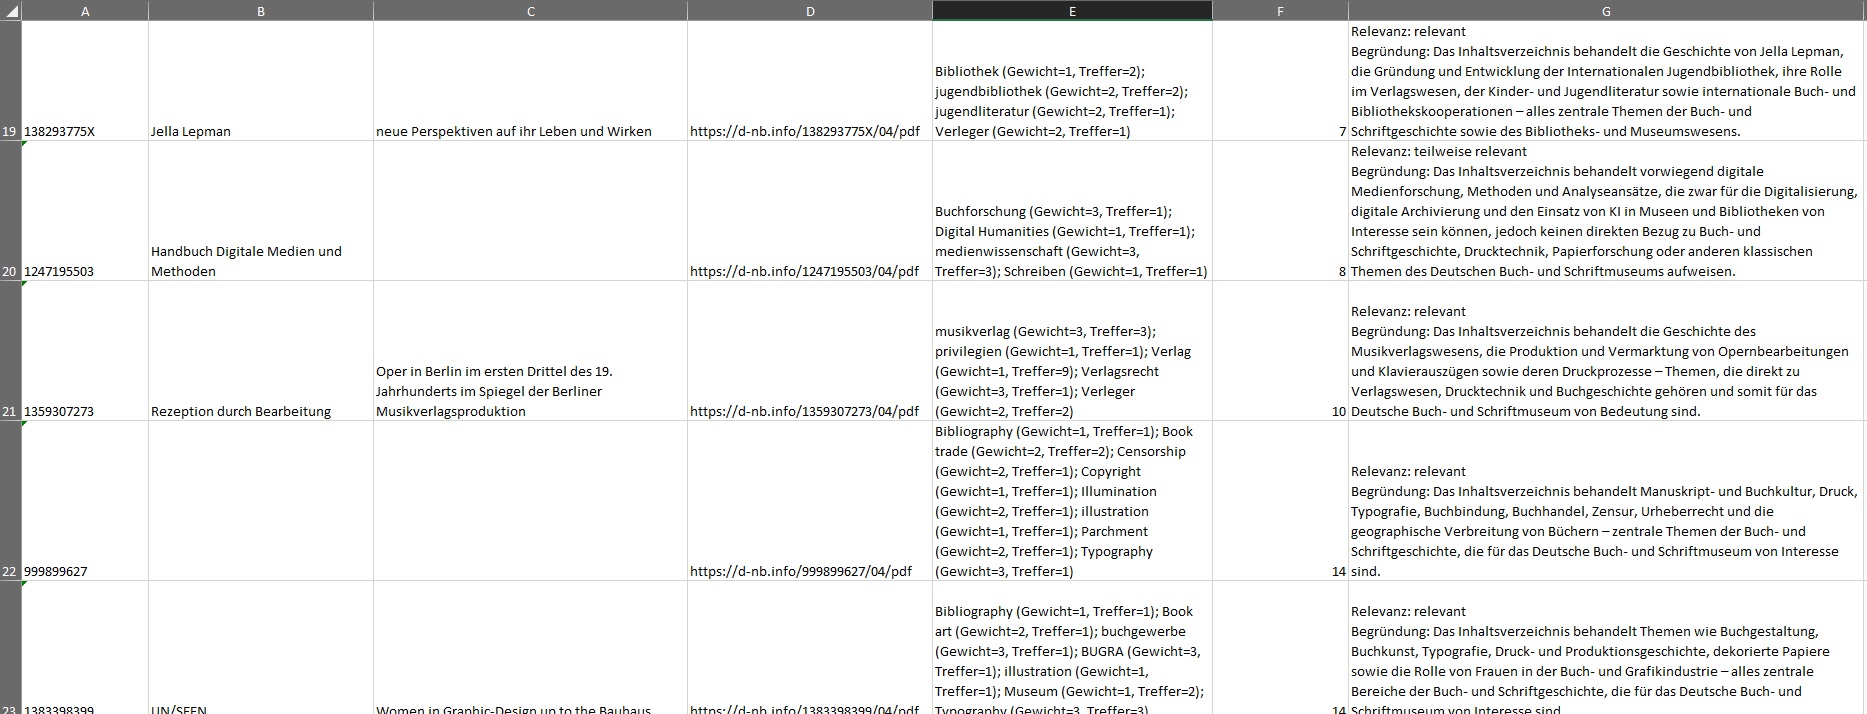
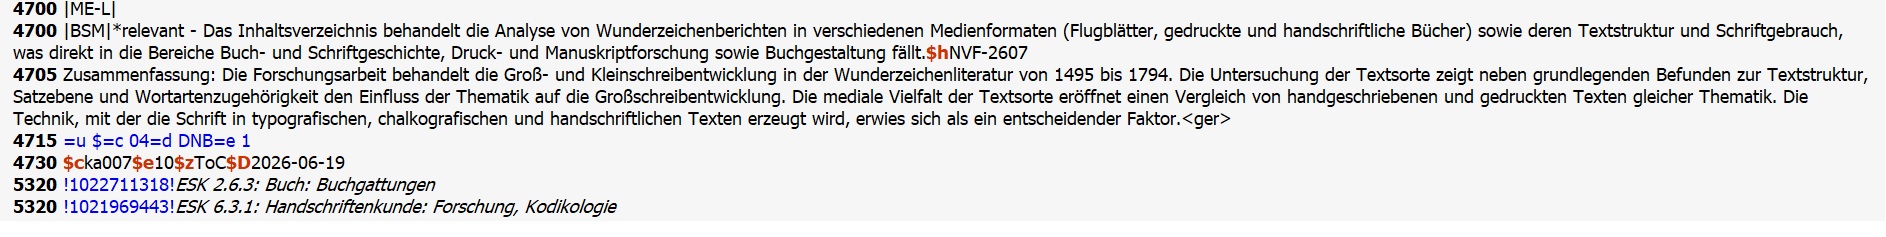
Zusätzlich begründet die KI ihre Einschätzung kurz in ein bis zwei Sätzen. Dadurch bleibt die Entscheidung nachvollziehbar und kann bei Bedarf fachlich überprüft werden.
Vom internen Arbeitsprozess zum InhaltsVZ-Tool für Externe
Der entwickelte Prozess hat sich im DBSM als hilfreiche und ressourcensparende Unterstützung bewährt. Daraus entstand die Überlegung, die gewonnenen Erfahrungen auch anderen Institutionen zugänglich zu machen. So entstand das InhaltsVZ-Tool, das im August gemeinsam mit dem DNB_Lab einer interessierten Community vorgestellt und diskutiert werden konnte. Dabei hat sich herausgestellt, dass die vorgestellte Lösung auch die Bedarfe anderer Institutionen aus dem GLAM-Bereich sehr interessant ist.
Das Video zeigt im Zeitraffer und gekürzt den kompletten Prozess des InhaltsVZ-Tool mit OAI-Schnittstelle, Stichwortanalyse und SRU-Schnittstelle. Danach werden die Ergebnisse in Excel präsentiert.
Die Anwendung bündelt wesentliche Schritte des Arbeitsprozesses und kann unabhängig von der KI eingesetzt werden. Sie umfasst drei zentrale Bereiche:
OAI-Schnittstelle
Über die OAI-Schnittstelle werden Datensätze mit vorhandenen Inhaltsverzeichnissen für einen gewählten Zeitraum ermittelt. Da Datensätze beispielsweise durch maschinelle Aktualisierungen mehrfach verändert werden können, kann dieselbe IDN zu unterschiedlichen Zeitpunkten erneut erscheinen. Die Datei idn.txt ermöglicht deshalb einen Abgleich mit bereits bekannten IDNs und verhindert, dass bereits verarbeitete Datensätze erneut übernommen werden.
Stichwortanalyse
Die digital vorliegenden Inhaltsverzeichnisse werden anhand der individuell festgelegten Stichworte durchsucht. Die Begriffe können gewichtet werden, sodass aus den einzelnen Treffern eine Gesamtgewichtung entsteht. Damit lässt sich die Suche an die jeweiligen Sammlungs- und Arbeitsschwerpunkte einer Institution anpassen.
SRU-Schnittstelle
Über die SRU-Schnittstelle können anschließend ausgewählte bibliografische Angaben ergänzt werden. Das Tool verwendet dazu die IDN aus der Excel-Datei, ruft den entsprechenden bibliografischen Datensatz ab und übernimmt die ausgewählten Angaben automatisch in die Ergebnisdatei.
Ein Werkzeug für unterschiedliche Anforderungen
Das InhaltsVZ-Tool ist dabei bewusst so aufgebaut, dass die drei Bereiche unabhängig voneinander genutzt werden können. Institutionen können die einzelnen Funktionen daher an ihren eigenen Arbeitsablauf anpassen. Die verwendete Stichwortdatei kann ebenfalls individuell gestaltet werden. Die vom DBSM bereitgestellten Stichworte dienen lediglich als Beispiel und können durch eigene Begriffe, Gewichtungen und – bei Bedarf – negative Gewichtungen ersetzt oder ergänzt werden.
Das Tool ist als Open-Source-Projekt auf GitHub verfügbar:
Automatisierung als Unterstützung der Facharbeit
Die Entwicklung des gesamten Geschäftsprozesses zeigt, wie sich bibliothekarische und museale Facharbeit durch digitale, maschinelle und KI-gestützte Verfahren sinnvoll und effizient unterstützen lässt. Dabei geht es nicht darum, fachliche Entscheidungen vollständig an Maschinen abzugeben. Vielmehr stellt sich angesichts begrenzter personeller Ressourcen immer wieder die Frage, wie vorhandene Arbeitskapazitäten möglichst sinnvoll eingesetzt werden können. Durch die Automatisierung wiederkehrender und zeitaufwendiger Arbeitsschritte – von der Ermittlung und Aufbereitung der Datensätze über die Stichwortanalyse bis hin zur KI-gestützten Relevanzprüfung – können große Datenmengen effizienter vorstrukturiert werden. So können Personalkapazitäten gezielter für Aufgaben eingesetzt werden, bei denen fachliche Bewertung, Einordnung und Expertise erforderlich sind – zum Beispiel im Bereich der Vermittlungsarbeit.
Das InhaltsVZ-Tool bildet dabei einen Teil dieses Geschäftsprozesses ab. Die Erfahrungen aus dem gesamten Prozess zeigen zugleich, welche weiteren Möglichkeiten sich durch die Kombination aus Automatisierung und KI für die wissenschaftliche Arbeit ergeben.
Isabell Sickert
Isabell Sickert arbeitet seit 2010 in der Deutschen Nationalbibliothek und seit 2025 für das Deutsche Buch- und Schriftmuseum im Bereich digitales Prozessmanagement.