
Metadaten on Track
Das bin ich…
Mein Name ist Sophie-Nathalie Hornauer. Ich bin Mitarbeitende des Referats Medieneingang am Standort Leipzig und studiere berufsbegleitend Informationsmanagement an der Hochschule Hannover. Im Rahmen meines Studiums absolvierte ich von Juli bis September 2026 mein elfwöchiges Pflichtpraktikum im Projekt „Politische Codes in Texten populärer Musik“, kurz: Polit Codes PopMusik. Am Projekt beteiligt waren Konstantin Freybe – Projektbetreuer und Mitarbeitender des Referat Wissenschaft und Jacob Tunger – Masterstudent der Digital Humanities an der Universität Leipzig.
Polit Codes PopMusik – eine Einführung
Mit Polit Codes PopMusik plant das Deutsche Musikarchiv (DMA) die Erschließung eines neuen Vermittlungsangebots im Bereich politische Bildung und Media Literacy. Zielgruppe sind dabei vor allen Dingen Schüler*innen der Sekundarstufe 2 sowie potenzielle Erstwähler*innen. Die Datengrundlage bildet der im Rahmen der Masterarbeit „Die Vermessung des Populären – Trends in 70 Jahren Pop- und Chartgeschichte: Eine diachrone Analyse von 255.000 Songtexten (1955–2024) mittels LLM-gestützter Interpretation und BERTopic“ entstandene Basisdatensatz, der sogenannte Songtextekorpus. Dieser wurde von Masterabsolvent Tim Henning auf Grundlage verschiedener Songtexte-Datenbanken, wie „Genius.com“ oder „Offiziellecharts.de“ entwickelt und soll mit den Beständen des DMA abgeglichen werden. Mit Hilfe computer- und korpuslinguistischer Methoden sollen semantische Muster identifiziert werden und später von Schüler*innen im Unterricht analysiert werden können. Im Fokus steht die Betrachtung von impliziten politischen Codes/Phrasen in den Songtexten. Dabei geht es um Inhalte wie Demokratiefeindlichkeit, Gewaltverherrlichung, Antisemitismus und Sexismus in populärer Musik. Die Entwicklung passender pädagogischer Veranstaltungsangebote findet zu einem späteren Zeitpunkt mit Partnern aus dem Bereich der politischen Bildung statt.
Metadatenanreicherung auf Basis des eigenen Bestandes
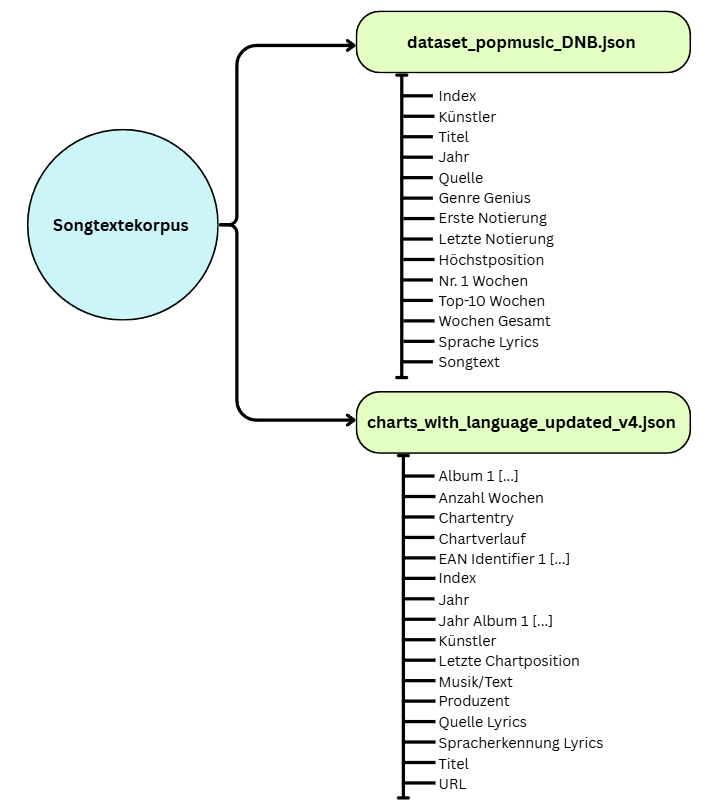
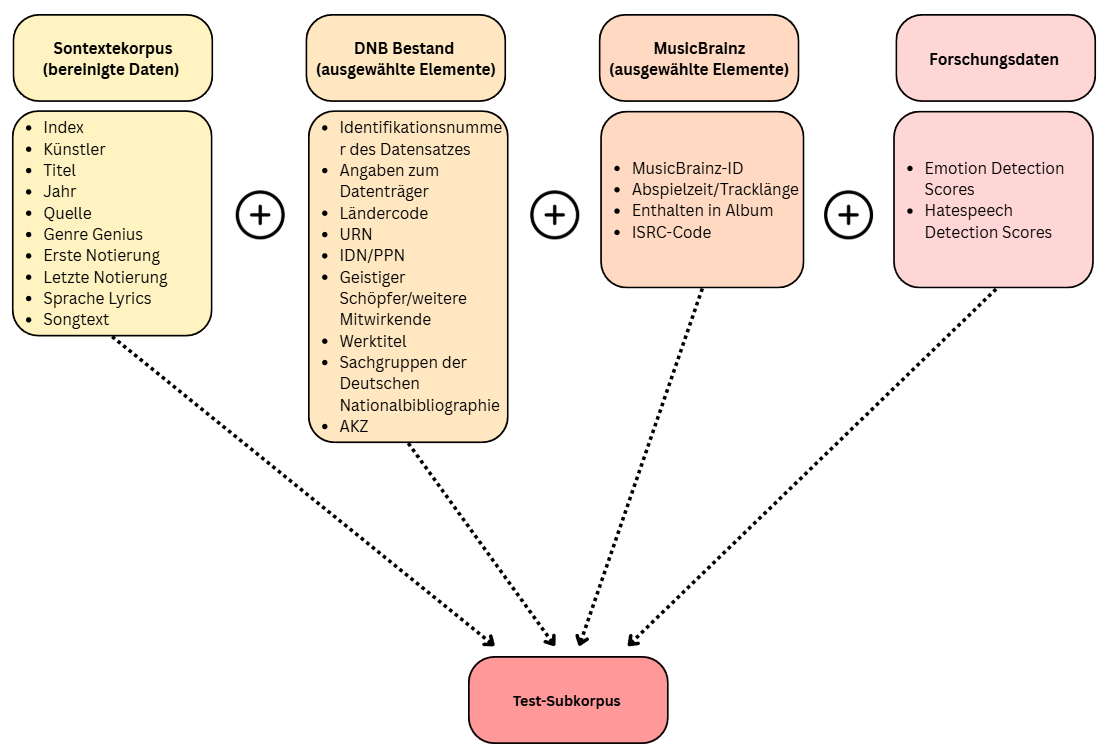
Mein Aufgabenfeld befasste sich vor allen Dingen mit der Anreicherung der bereits vorhandenen Songtexte-Datensätze mit weiteren bibliothekarisch standardisierten Metadaten sowie die Verknüpfung dieser mit dem eigenen Bibliotheksbestand. Zunächst einmal betrachtete ich die in zwei JSON-Dateien vorliegenden Basisdaten aus dem Songtextekorpus. Dies diente dem Kennenlernen der Datenstruktur sowie der Orientierung im Datenschema und lieferte wichtige Anhaltspunkte zum Ist-Zustand der vorliegenden Informationen. Neben Angaben zu Titel, Künstler und Jahr enthielten die beiden Basisdatensätze außerdem weitere Elemente, wie z.B. den Songtext, die Sprache der Lyrics sowie einen Vermerk, wenn das Album in den deutschen Charts vertreten war. Damit für die geplante Verknüpfung der Inhalte nun vor allen Dingen qualitativ hochwertige Angaben dem DNB-Bestand entnommen werden konnten, verschaffte ich mir im nächsten Schritt einen Überblick über die aktuell gültigen übergeordneten sowie hauseigenen Musikerschließungsstandards. Mit Hilfe der STA RDA DACH Plattform, dem ILTIS-Handbuch, bereits vollständig erschlossenen Tonträgerdatensätzen aus dem DNB-Bestand sowie einer gezielten tabellarischen Gegenüberstellung der einzelnen Elemente ermittelte ich schließlich diejenigen Elemente, welche für die Ergänzung der Songtexte-Datensätze in Frage kamen. Darunter fielen der Ländercode, Angaben zum Datenträger sowie die systemintern vergebenen Datensatzidentifikationsnummern (IDN/PPN) und die Akzessionsnummer (AKZ). Eine Voraussetzung für die Anreicherung der Datensätze stellte außerdem die Verwendung persistenter Identifikatoren (PIDs) dar. Als PIDs wurden neben der URN auch sämtliche Elemente ausgewählt, die im Datensatz des physischen Medienwerks eine Verknüpfung zur Gemeinsamen Normdatei (GND) oder anderen Bibliotheksstandards, wie beispielsweise der Dewey-Dezimalklassifikation (DDC) aufwiesen. Das waren neben dem Geistigen Schöpfer und weiteren Mitwirkenden auch der Werktitel sowie die für die inhaltliche Beschreibung der Tonträger vergebenen DDC Sachgruppen.
Projekt MIAMI
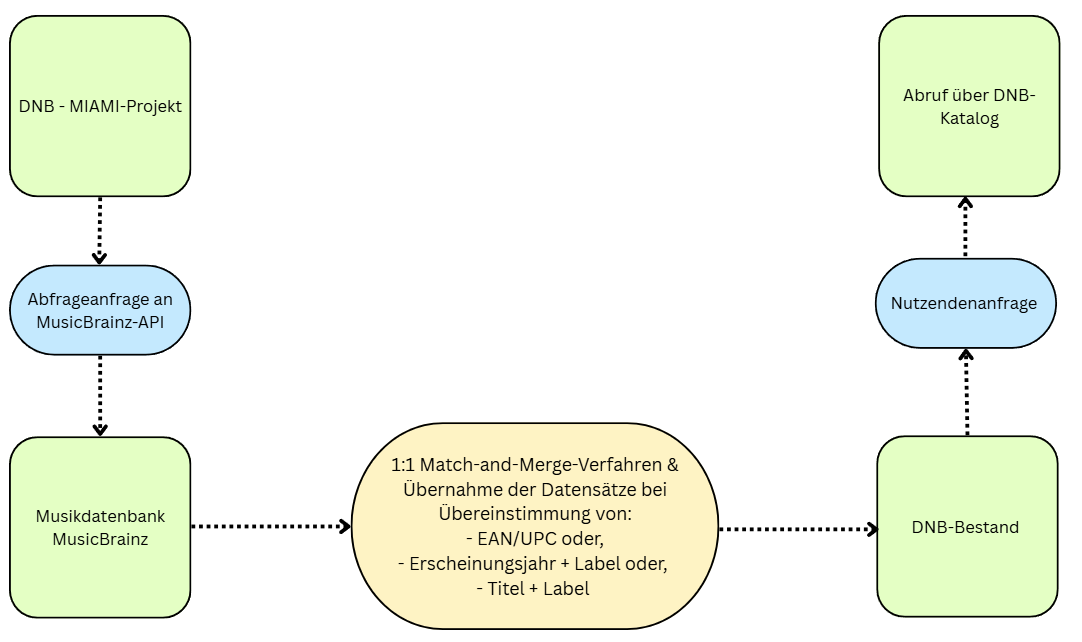
Im Zuge meiner Recherchen wurde ich außerdem auf ein weiteres hausinternes Projekt aufmerksam. Das MIAMI Projekt beschäftigt sich mit der Einspielung von Musik-Trackdatensätzen in den Bibliotheksbestand. Zur Orientierung: RDA Regelwerkskonform findet die Erschließung von Musiktonträgern in der Deutschen Nationalbibliothek auf Albumebene statt. Wichtige Informationen auf Trackebene, wie z.B. einzelne Tracktitel oder trackbasierte Identifikatoren werden bei der intellektuellen Erschließung der Medienwerke momentan nicht erfasst. MIAMI versucht dieser Problematik entgegenzuwirken und bezieht dafür täglich bis zu 30.000 Trackdatensätze aus der Musikdatenbank MusicBrainz. Die einzelnen Titel werden in einem automatisierten 1:1 Match-and-Merge-Verfahren der Datenbank entnommen, mit dem Bibliotheksbestand abgeglichen und bei eindeutiger Übereinstimmung direkt in den Katalog der DNB eingespeist. Dabei erhält jeder Track einen eigenen Datensatz und ist so individuell recherchier- und auffindbar. Seit Juni 2026 wurden über 850.000 Trackdatensätze in den Bestand übernommen. Die eingespielten MusicBrainz Datensätze enthalten neben diversen bibliografischen Informationen zum jeweiligen Tracktitel auch eine Verknüpfung zu einem im Bestand befindlichen (Original-)album. Diese Verbindung konnte für das weitere Vorgehen im Projekt Polit Codes PopMusik nachgenutzt werden und erleichterte die Verknüpfung zum eigenen Bestand. Weitere Informationen zum Projekt finden Sie hier.
Parallel zu meinen Recherchen beschäftigte sich Masterstudent Jacob Tunger mit der Bereinigung und Vereinheitlichung der beiden JSON-Basisdatensätze, verschiedenen Verfahren für die automatisierte Textanalyse sowie die visuelle Aufbereitung der Ergebnisse via „Streamlit“, unterschiedlichen BERT-basierten Klassifikationsmodellen und dem Matching von DNB- und den Songtexte-Datensätzen. Mehr Informationen dazu finden Sie hier.
Im Folgenden wurden die verschiedenen Metadaten aus Songtextekorpus und eigenem Bestand in mehreren Testläufen mittels Mapping- und Merging-Verfahren miteinander verknüpft und um die durch Emotion- und Hatespeech-Detection-Analyse und ähnliche Verfahren erhaltenen Forschungsdaten ergänzt. Dabei konnten aufgetretene Probleme und Fehler behoben und Verfahrensabläufe angepasst und optimiert werden. Das Endergebnis war ein auf 3000 Titel dezimierter Test-Subkorpus, welcher vor allen Dingen deutschsprachige, in den Charts vertretene Songtitel sowie alle angereicherten Metadaten enthielt. Dieser wurde nachfolgend für alle weiteren projektbezogenen Vorhaben genutzt.
Musik neu vernetzt
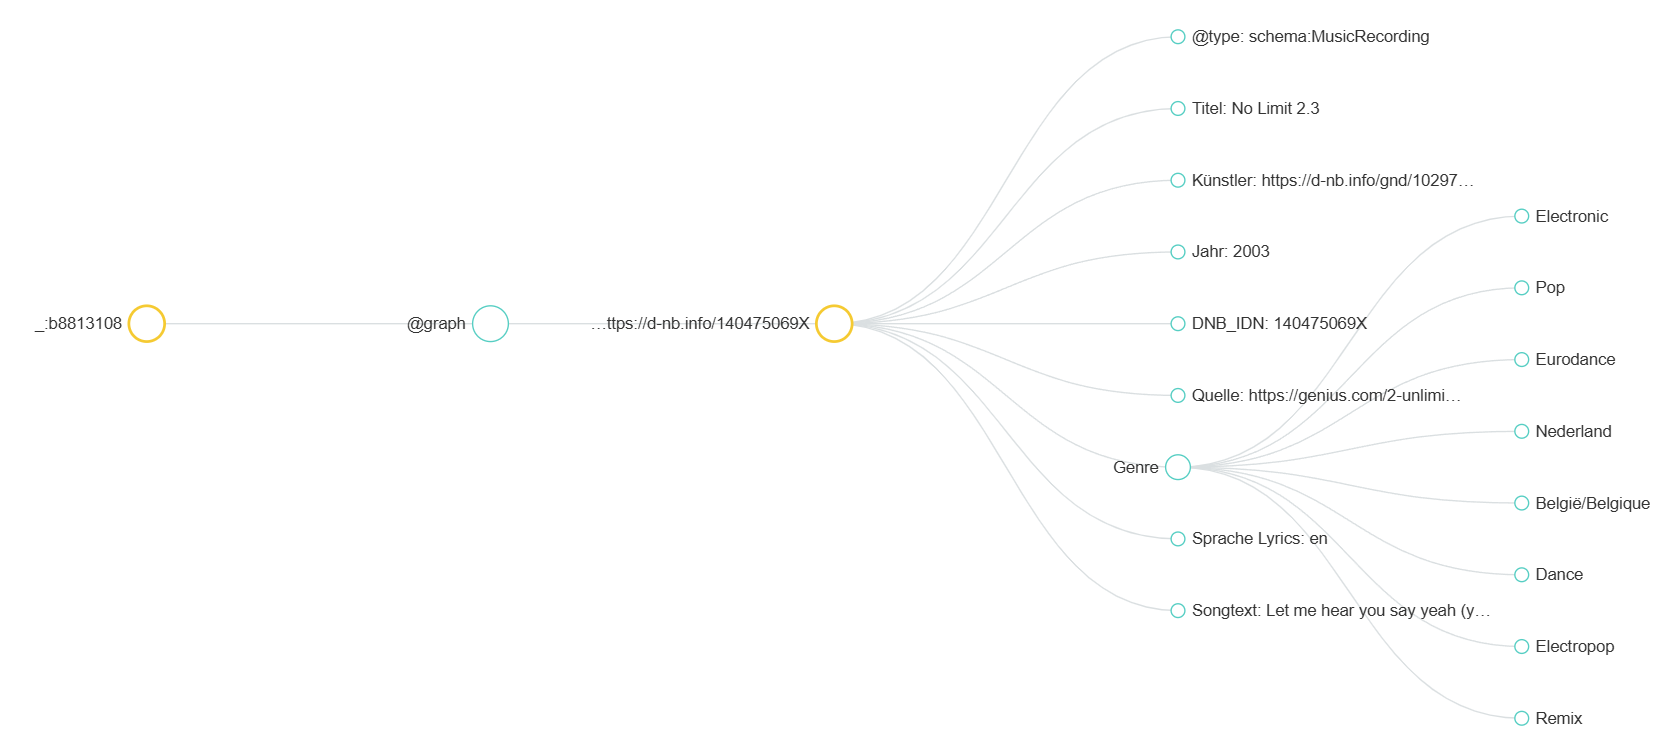
Zum Ende meines Praktikums beschäftigte ich mich mit den verschiedenen Möglichkeiten der Datenmodellierung. Aufgrund diverser Vorteile fiel die Wahl auf das RDF-Modell. Im Vergleich zur klassischen JSON-Struktur, wie in den vorliegenden Datensätzen gegeben, bietet RDF durch die Verknüpfung von Daten flexiblere Abfragemöglichkeiten, ist interoperabel mit anderen Systemen einsetzbar sowie problemlos erweiterbar und maschinenlesbar. Das passende Modellierungsvokabular lieferte Schema.org mit Properties aus MusicRecording und CreativeWork sowie DublinCore mit Properties aus den DCMI Metadata Terms, /terms/. Die Grundlage für das weitere Vorgehen bildete ein einzelner Dummy-Datensatz aus dem Test-Subkorpus. Im Folgenden wurden die einzelnen Elemente mit den entsprechenden Properties aus den o.g. Vokabularen und eindeutigen URIs versehen. Für die Überprüfung der semantischen Datenmodellierung kam der JSON-LD Playground zum Einsatz. Der fertige JSON-LD Datensatz bildete den Ausgangspunkt für die abschließende RDF-Visualisierung.
Fazit und Ausblick
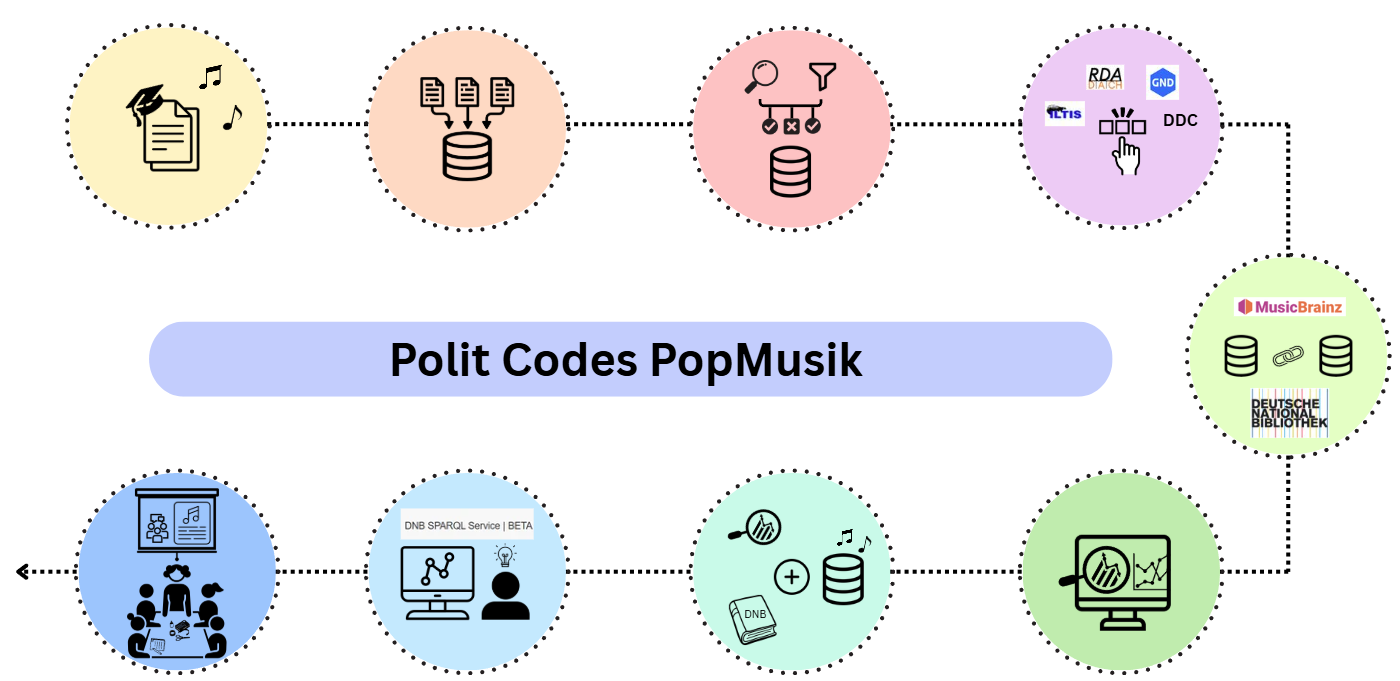
Die im Rahmen der Musikerschließung verwendeten und für die Metadatenanreicherung in Frage kommenden Elemente konnten mit Hilfe diverser bibliothekarischer Regelwerke und Standards erfolgreich identifiziert und im Verlauf des Projekts vielseitig nachgenutzt werden. Die Ergebnisse des MIAMI Projekts eröffneten außerdem neue Möglichkeiten für den Abgleich und die anschließende Verknüpfung der Songtexte-Datensätze mit dem DNB-Bestand. Durch ihren Linked-Open-Data (LOD) Charakter erweitern die RDF-modellierten Metadaten die Datensammlung der Deutschen Nationalbibliothek und dienen als technisches Fundament für die Abfrage der Daten via hauseigenem SPARQL-Endpoint. Dies macht den entstandenen Songtextekorpus auch für andere Zielgruppen, z.B. Forschende der Musik-/Politikwissenschaft, Bibliotheken etc. interessant. Die nun geschaffene Datenbasis bildet einen guten Ausgangspunkt für die Entwicklung eines passenden Vermittlungsangebots, offene Aufgaben, wie die Optimierung des Matchingverfahrens von Songtexte- und MusicBrainz/DNB-Datensätzen gilt es im weiteren Projektverlauf zu lösen.
Praktikant*innen willkommen! Studierende, die ein Pflichtpraktikum ableisten müssen und ihre Kenntnisse und Fähigkeiten in den Digital Humanities auf die vielfältigen Bestände und Sammlungen des Hauses anwenden möchten, wenden sich gerne an Konstantin Freybe.
Sophie-Nathalie Hornauer
ist Mitarbeitende des Referats Medieneingang am Standort Leipzig und studiert berufsbegleitend Informationsmanagement an der Hochschule Hannover. Im Rahmen ihres Studiums absolvierte sie ihr Pflichtpraktikum im Projekt Polit Codes Popmusik. Das Projekt wurde von Konstantin Freybe betreut.