
Vom Songtext zu politischer Bildung
Ein achtwöchiges Teilzeitpraktikum zwischen Digital Humanities, Datenaufbereitung und computergestützter Textanalyse
WER BIN ICH UND WAS MACHE ICH?
Mein Name ist Jacob Tunger und ich studiere Digital Humanities im Master an der Universität Leipzig. Im Rahmen meines Studiums absolviere ich ein achtwöchiges Teilzeitpraktikum bei Konstantin Freybe, wissenschaftlicher Mitarbeiter an der Deutschen Nationalbibliothek. Dabei arbeite ich eng mit meiner Mitpraktikantin Sophie-Nathalie Hornauer zusammen. Inhaltlich bewegt sich mein Praktikum an der Schnittstelle von Daten, computergestützter Textanalyse und der Frage, wie digitale Methoden für Bildungsangebote nutzbar gemacht werden können.
INHALTLICHER RAHMEN UND ZIELE
Hintergrund des Praktikums ist ein Vorhaben des Deutschen Musikarchivs an der Deutschen Nationalbibliothek (DNB), bis 2028 ein Bildungsprojekt zu entwickeln, das Schülerinnen und Schüler interaktiv mit ihren Lieblingssongs und den darin behandelten Themen in Kontakt bringt. Musik soll dabei nicht nur als Unterhaltungsgegenstand betrachtet werden, sondern als Ausgangspunkt für die Auseinandersetzung mit gesellschaftlichen und politischen Fragestellungen dienen. Konkret ist die Frage von Interesse, welche – mal mehr, mal weniger – impliziten politischen Einstellungen in Texten populärer Musik zum Ausdruck kommen und wie sie explizit, das heißt in diesem Kontext besonders: für junge Menschen sichtbar und nachvollziehbar gemacht werden können.
Mein Praktikum reiht sich in die technische Vorbereitung dieses Vorhabens ein. Dabei geht es erstmal darum, Grundlagen zu schaffen, auf denen Bildungsexpertinnen und -experten später aufbauen können. Zwei Aufgaben stehen dabei im Mittelpunkt: Zum einen soll eine technische Basis entstehen, mit der die vorhandenen Songtextdaten aufbereitet, verfügbar gemacht, visualisiert und interaktiv untersucht werden können. Zum anderen geht es um die computergestützte Klassifikation der Texte nach unterschiedlichen inhaltlichen Merkmalen, insbesondere nach Themen, die für politische Bildung relevant sein können.
Meine Arbeit baut dabei auf der Masterarbeit von Tim Henning auf, die in Kooperation mit der Deutschen Nationalbibliothek entstanden ist. Die Arbeit trägt den Titel „Trends in 70 Jahren Pop- und Chartgeschichte: Eine diachrone Analyse von 255.000 Songtexten (1955–2024) mittels LLM-gestützter Interpretation und BERTopic“.
Im Zentrum dieser Masterarbeit stand der Aufbau und die inhaltliche Erschließung eines umfangreichen Songtextkorpus. Dafür wurden rund 255.000 Songtexte aus sieben Jahrzehnten Pop- und Chartgeschichte zusammengetragen und mit Methoden der automatisierten Textanalyse untersucht. Ein besonderer Schwerpunkt lag auf dem Einsatz großer Sprachmodelle (Large Language Models, LLMs) und des Topic-Modeling-Verfahrens BERTopic. Während die Sprachmodelle genutzt wurden, um Texte beziehungsweise darin enthaltene Themen inhaltlich zu erschließen, konnte BERTopic dazu beitragen, wiederkehrende thematische Strukturen im Korpus sichtbar zu machen.
Das Ziel war damit nicht nur, einzelne Songs zu analysieren, sondern Entwicklungen über einen langen Zeitraum hinweg zu untersuchen: Welche Themen finden sich in der Popmusik? Wie verändern sich diese Themen über die Jahrzehnte? Und welche gesellschaftlichen Entwicklungen lassen sich möglicherweise in der Musikgeschichte wiederfinden? Die Ergebnisse und insbesondere das dabei entstandene Korpus bilden die Ausgangsbasis für die weiteren Arbeiten im Rahmen meines Praktikums.
EIGENE ARBEITEN UND INHALTE
ERSTE SICHTUNG UND BEREINIGUNG DER DATEN
Die Songtextdaten bilden die Grundlage für alle weiteren Arbeitsschritte. Bevor ich mich deshalb mit der eigentlichen Klassifikation beschäftigen konnte, war zunächst ein genauer Blick auf die vorhandenen Daten notwendig. Gerade bei größeren Datensätzen ist es wichtig zu wissen, womit man tatsächlich arbeitet: Welche Informationen liegen vor? Wie sind die Daten strukturiert? Welche Einträge sind vollständig? Und wo gibt es mögliche Fehler oder Inkonsistenzen?
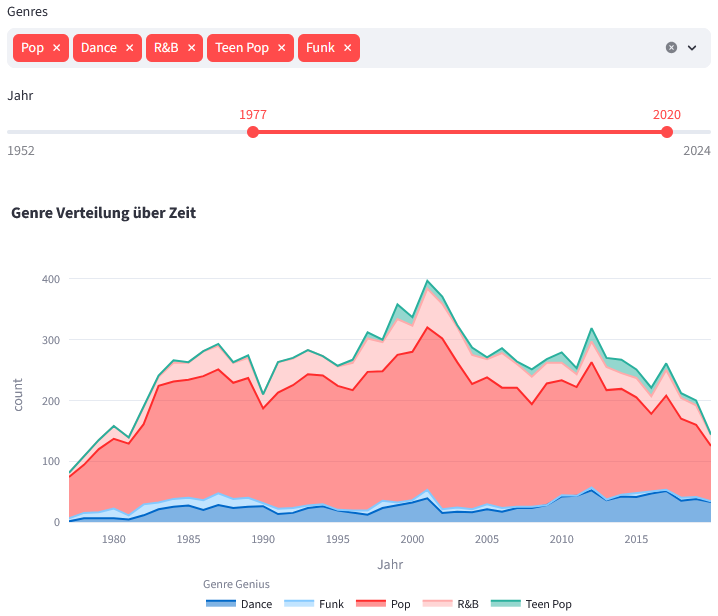
Um einen ersten Überblick zu schaffen, habe ich deshalb eine visuelle Anwendung mit der Python Bibliothek Streamlit entwickelt. Sie ermöglicht es, den Datensatz auf einfache Weise zu erkunden und grundlegende Eigenschaften des Korpus sichtbar zu machen. Eine solche Übersicht ist nicht nur für die eigene Arbeit hilfreich. Sie kann auch für Personen interessant sein, die später mit den Daten arbeiten, ohne selbst tief in die technische Struktur des Datensatzes eingestiegen zu sein.
Im nächsten Schritt ging es um die Bereinigung und Vereinheitlichung der Daten. In der ursprünglichen Masterarbeit waren die Informationen auf zwei JSON-Dateien verteilt und über einen Index miteinander verknüpft. Für die weitere Arbeit habe ich daraus zwei kompaktere, zusammengeführte Datenbasen erstellt, in denen nur noch vollständige Informationen vorliegen. Zusätzlich wurde der Datensatz in deutsch- und englischsprachige Songs aufgeteilt. Dadurch lassen sich spätere Analysen gezielter auf bestimmte Sprachräume und die jeweils passenden Verfahren anwenden.
COMPUTERGESTÜTZTE TEXTKLASSIFIKATION
Nachdem die Datengrundlage aufbereitet war, stellte sich die Frage, welche computergestützten Methoden für die geplante politische Bildungsarbeit sinnvoll eingesetzt werden können. Dazu habe ich zunächst einen Überblick über verschiedene Verfahren der automatisierten Textanalyse zusammengestellt.
Dabei wurde deutlich, dass nicht allein die technisch aktuellste Methode automatisch die pädagogisch sinnvollste sein muss. Ein Verfahren, wie die Sentimentanalyse über Wortlisten, ist beispielsweise deutlich weniger komplex als moderne Transformer-Modelle und kann in vielen Fällen auch weniger präzise sein. Gleichzeitig bietet gerade eine solche Methode interessante Möglichkeiten für die Vermittlung: Lernende können nachvollziehen, wie ein Ergebnis zustande kommt, eigene Begriffe hinzufügen und die Auswirkungen ihrer Entscheidungen unmittelbar beobachten.
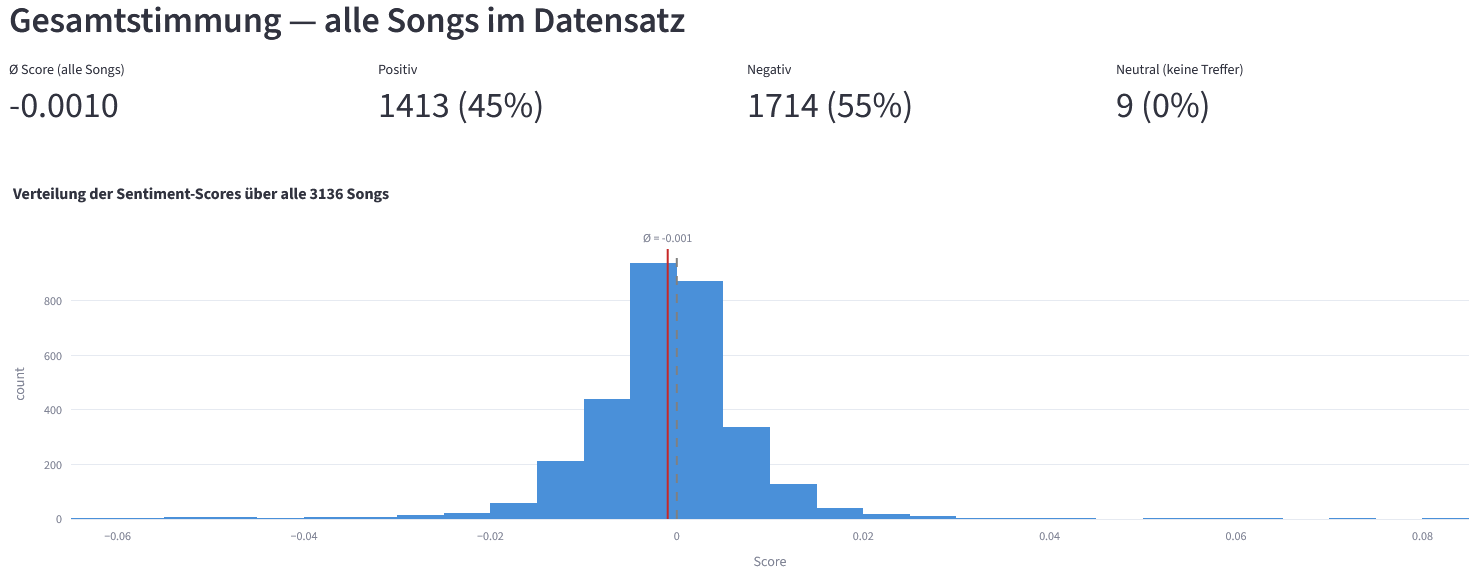
Aus diesem Grund habe ich eine weitere Streamlit-Anwendung entwickelt. In dieser kann ein Datensatz eingelesen und ein eigenes Wörterbuch für die Sentimentanalyse erstellt werden. Einzelnen Wörtern lassen sich dabei Gewichtungen zwischen -1 und 1 zuweisen. Anschließend wird anhand der Häufigkeit des Vorkommens dieser Wörter berechnet, welche Songs besonders positive oder negative Werte erhalten. Auf diese Weise wird ein ansonsten eher abstrakter Analyseprozess interaktiv nachvollziehbar.
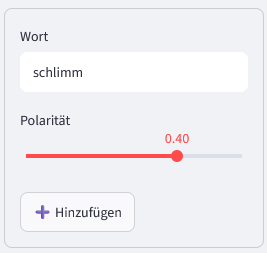
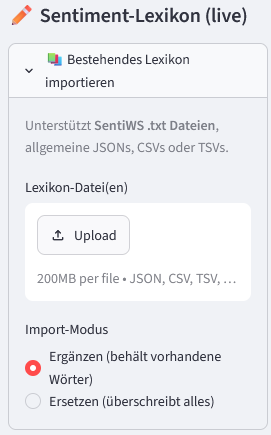
Figure 3 interaktive Elemente für die eigene Sentimentanalysen; Foto: Jacob Tunger
Neben einem selbst erstellten Wörterbuch kann auch ein bereits vorhandenes Lexikon geladen werden. Ein passendes Beispiel ist “SentiWS”, ein deutschsprachiges Sentimentlexikon. Es steht über “Wortschatz Leipzig” zur Verfügung, einer Plattform, die vom Institut für Informatik der Universität Leipzig in Kooperation mit der Sächsischen Akademie der Wissenschaften bereitgestellt wird. Dort finden sich verschiedene Textkorpora und sprachwissenschaftliche Ressourcen, die für die computergestützte Analyse genutzt werden können.
Neben diesen eher klassischen und didaktisch gut nachvollziehbaren Verfahren lag ein weiterer Schwerpunkt auf modernen BERT-basierten Klassifikationsmodellen. Hier ging es vor allem darum zu prüfen, welche Modelle für die vorhandenen Daten geeignet sind, welche Ergebnisse sie liefern und welcher technische Aufwand bei ihrer Anwendung entsteht.
Zur Analyse der Songtexte wurden drei bereits trainierte KI-Sprachmodelle eingesetzt, die über die Plattform Hugging Face frei verfügbar sind: „bhadresh-savani/bert-base-uncased-emotion“ zur Emotionserkennung, „facebook/roberta-hate-speech-dynabench-r4-target“ zur Erkennung von Hate Speech sowie „cardiffnlp/twitter-xlm-roberta-base-sentiment“ zur Sentimentanalyse. Alle drei Modelle wurden nicht selbst entwickelt, sondern von anderen Forschungsteams bereits mit großen Textmengen trainiert, sodass sie direkt auf neue Texte, hier Songtexte, angewendet werden können.
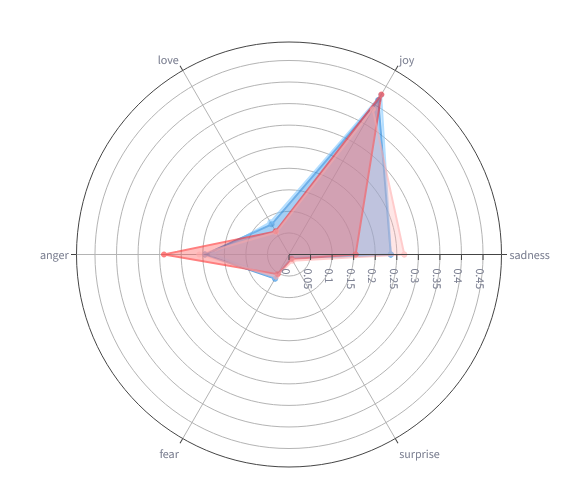
Das erste Modell ordnet einen Text einer von sechs grundlegenden Emotionen zu: Traurigkeit, Freude, Liebe, Wut, Angst oder Überraschung. Es liefert also für jeden Songtext eine Einschätzung, welche Gefühlslage am stärksten zum Ausdruck kommt.
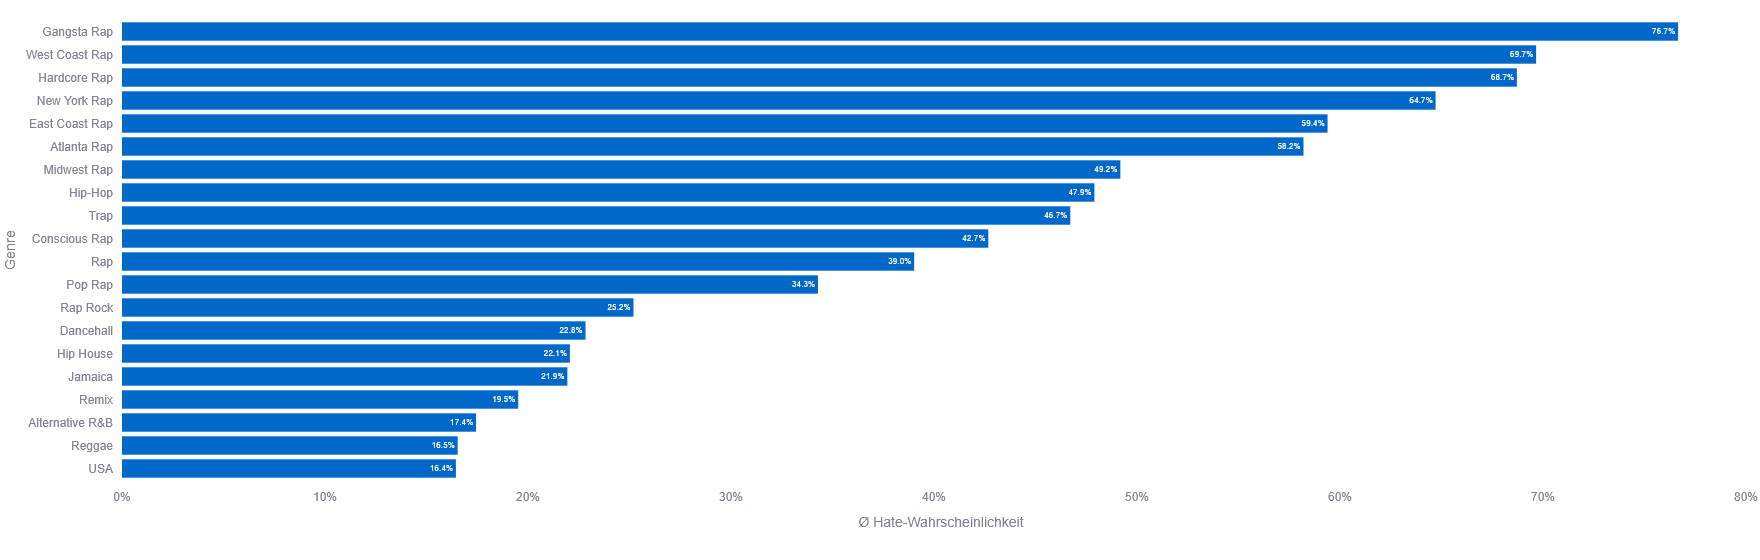
Das zweite Modell wurde speziell darauf trainiert, Hassrede zu erkennen, also Sprache, die Personen oder Gruppen aufgrund von Merkmalen wie Herkunft, Religion oder Geschlecht abwertet oder angreift. Es trifft eine einfache Ja-Nein-Entscheidung: Enthält der Text Hassrede oder nicht.
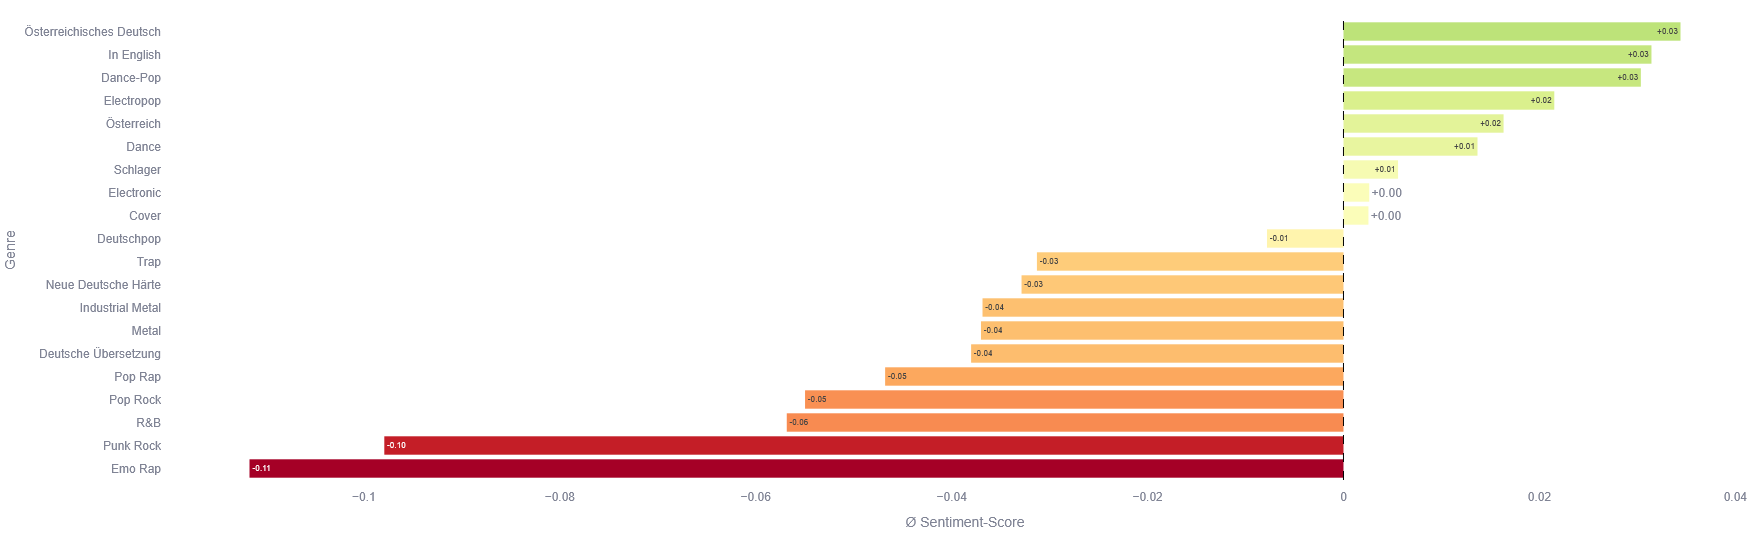
Das dritte Modell schätzt die grundsätzliche Stimmung eines Textes ein und unterscheidet dabei zwischen negativ, neutral und positiv. Da es ursprünglich mit mehrsprachigen Texten aus sozialen Medien trainiert wurde, kann es auch auf nicht-englische Songtexte angewendet werden.
Alle drei Modelle wurden zunächst auf einem kleineren Ausschnitt des Textkorpus getestet. Dabei ging es weniger darum, bereits vollständige und belastbare Ergebnisse zu erzielen, sondern vor allem darum, einen ersten funktionierenden Prototyp zu entwickeln. Die Tests sollten zeigen, welche Art von Ergebnissen grundsätzlich zu erwarten ist – etwa wie plausibel die Einschätzungen der Modelle bei Songtexten ausfallen – und welche Rechenzeit sowie welche technische Ausstattung nötig sind, wenn später deutlich größere Datenmengen verarbeitet werden sollen. Um die Ergebnisse, die so ein
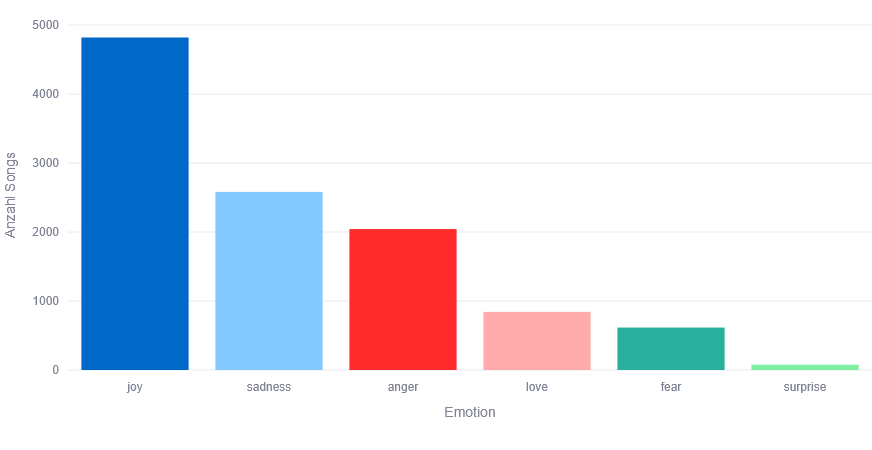
KI-Modell liefert, etwas begreifen zu können und auch hier erste Grundlagen für die Weiterentwicklung zu liefern, habe ich die Ergebnisse der jeweiligen Modelle auch in Streamlit Anwendungen interaktiv visualisiert.
MATCHING MIT DATEN DER DEUTSCHEN NATIONALBIBLIOTHEK
Ein weiterer wichtiger Bestandteil der Arbeit ist die Anreicherung des Songtextkorpus mit bereits vorhandenen Daten der Deutschen Nationalbibliothek. Je dichter der Korpus mit zusätzlichen Metadaten verknüpft werden kann, desto mehr Möglichkeiten ergeben sich später für Suche, Filterung, Visualisierung und pädagogische Anwendungen.
Für das Matching gibt es unterschiedliche methodische Ansätze. Als ersten Schritt habe ich versucht, möglichst eindeutige Übereinstimmungen über die Kombination aus Künstler, Erscheinungsjahr und Titel zu finden. Bei einem exakten Match lassen sich Datensätze relativ zuverlässig miteinander verbinden. Allerdings zeigt sich schnell ein grundlegendes Problem: Namen und Titel werden in unterschiedlichen Datenquellen nicht immer gleich geschrieben.
Schon kleine Abweichungen – etwa unterschiedliche Groß- und Kleinschreibung, zusätzliche Zeichen, alternative Schreibweisen von Künstlernamen oder Unterschiede bei Sonderzeichen – können dazu führen, dass zwei eigentlich zusammengehörige Einträge nicht als identisch erkannt werden. Ein rein exaktes Matching findet deshalb zwar sehr zuverlässige Treffer, lässt aber zugleich viele potenzielle Verbindungen unberücksichtigt.
Damit bildet das exakte Matching einen ersten, vergleichsweise sicheren Schritt. Für eine möglichst vollständige Verknüpfung des Korpus müssen anschließend weitere Verfahren geprüft werden, die auch ähnliche, aber nicht wortwörtlich identische Einträge erkennen können. Einige Versuche mit dem so genannten “Fuzzy-Matching” sind zwar theoretisch der nächste sinnvolle Schritt, erste Ergebnisse mit dieser Methode sind jedoch dennoch nicht vollends überzeugend gewesen.
ZWISCHENFAZIT, LIMITATIONEN UND AUSBLICK
Die bisherigen Arbeiten bilden damit verschiedene Bausteine für die weitere Entwicklung des Bildungsprojekts. Ausgehend von einem umfangreichen Songtextkorpus wurden zunächst die Datenstruktur untersucht und eine bereinigte, besser nutzbare Datengrundlage geschaffen. Darauf aufbauend entstanden interaktive Anwendungen, mit denen die Daten erkundet und einfache Klassifikationsverfahren nachvollziehbar eingesetzt werden können. Gleichzeitig wurden moderne BERT-basierte Modelle auf einem Unterkorpus getestet, um ihre Möglichkeiten und ihren technischen Aufwand besser einschätzen zu können. Hier müsste für eine wissenschaftlich fundiertere Ausarbeitung noch Test Scores errechnet werden, bei denen die Computerergebnisse mit menschlich annotierten Daten verglichen werden können. Nur das kann wissenschaftlich fundierte Ergebnisse über die Aussagekraft der Klassifikationen bieten, war jedoch aufgrund der limitierten Zeit eines 8-wöchigen Teilzeitpraktikums nicht mehr möglich. Gleiches gilt für aussagekräftige Ergebnisse für einen Matching Algorithmus.
Von Vorteil, wenn es schlussendlich um Bildungsarbeit geht, ist hierbei zum Glück ein anderer: Eine Methode muss nicht nur gute Ergebnisse liefern, sondern auch dazu passen, wie Schülerinnen und Schüler später mit den Daten arbeiten sollen. Die weitere Entwicklung wird deshalb vor allem davon abhängen, welche Formen der Interaktion und welche Arten von thematischen Klassifikationen für die politische Bildungsarbeit tatsächlich einen Mehrwert bieten. Im Vordergrund sollte stehen, was Schülerinnen und Schüler zum eigenständigen Reflektieren und Diskutieren bringen kann und nicht nur, welche computergestützte Methode die besten Ergebnisse liefert. Deshalb lag ein wichtiger Teil meiner Arbeit hier auch am Bereitstellen visueller und interaktiver Tools, die eine Grundlage für die Bildungsarbeit liefern und zunächst sehr “numerische” Ergebnisse besser greifbar machen können.
Die potenziell nächsten Schritte liegen unter anderem in der Verbesserung des Matchings mit den Daten der Deutschen Nationalbibliothek, der weiteren Untersuchung geeigneter Klassifikationsmodelle und der Frage, wie sich die gewonnenen Informationen sinnvoll visualisieren und für Lernende zugänglich machen lassen. Die im Praktikum entwickelten Prototypen sollen dabei vor allem als technische und konzeptionelle Grundlage für die weitere Arbeit dienen.
Praktikant*innen willkommen! Studierende, die ein Pflichtpraktikum ableisten müssen und ihre Kenntnisse und Fähigkeiten in den Digital Humanities auf die vielfältigen Bestände und Sammlungen des Hauses anwenden möchten, wenden sich gerne an Konstantin Freybe.
Jacob Tunger
studiert Digital Humanities an der Universität Leipzig und hat in der Deutschen Nationalbibliothek sein Pflichtpraktikum für das Erreichen seines Masterabschlusses im Frühjahr 2027 abgeleistet. Das Praktikum wurde von Konstantin Freybe betreut. Ziel war es, Methoden und Werkzeuge der Digital Humanities für die computergestützte Songtextanalyse im Rahmen eines Bildungsprojektes der DNB kennenzulernen und zu erschließen.